Když jsme začínali budovat MIKISI, stáli jsme před zásadním rozhodnutím: jakou technologii použít pro vytěžování faktur? Na trhu existovaly osvědčené přístupy — OCR se šablonami, manuální zpracování s pomocnými nástroji, specializované enterprise platformy. Rozhodli jsme se jít jinou cestou.
V tomto článku vám vysvětlíme, proč jsme zvolili kombinaci OCR a AI bez šablon, jak náš technologický stack funguje a jaké výhody tento přístup přináší. Půjdeme do technických detailů, ale srozumitelně — abyste pochopili, co se děje „pod kapotou", když nahrajete fakturu do MIKISI.
Pokud vás zajímá základní přehled o vytěžování faktur, začněte článkem Úvod do vytěžování faktur.
Obsah
- Proč ne šablony
- Náš technologický stack
- OCR vrstva — čtení textu
- AI analýza — porozumění struktuře
- Kontrolní pravidla
- Proč kombinace funguje
- Výhody našeho přístupu
- Často kladené otázky
Proč ne šablony
Šablonový přístup funguje skvěle v určitých scénářích: máte 5 hlavních dodavatelů, jejich faktury se nemění, objemy jsou vysoké. Nastavíte šablonu jednou a funguje měsíce bez zásahu.
Ale my jsme viděli jinou realitu. Účetní kanceláře zpracovávají faktury od stovek různých firem. Malé firmy mají desítky dodavatelů, kteří se mění. Každý dodavatel má jiný formát faktury. A dodavatelé své faktury občas mění — nový design, jiné umístění údajů.
Šablonový přístup v této situaci selhává:
- Pro každého nového dodavatele musíte vytvořit šablonu
- Při změně formátu faktury musíte šablonu aktualizovat
- Údržba šablon pro stovky dodavatelů je noční můra
- Faktury bez šablony musíte zpracovat ručně
Chtěli jsme nástroj, který funguje hned po registraci. Nahrajete fakturu od kteréhokoli dodavatele a systém ji zpracuje. Bez předchozího nastavování, bez vytváření šablon, bez učení systému.
💡 Naše filozofie: Uživatel by neměl být IT specialista. Měl by nahrát fakturu a dostat data. Veškerá komplexita by měla být skrytá pod kapotou.
Náš technologický stack
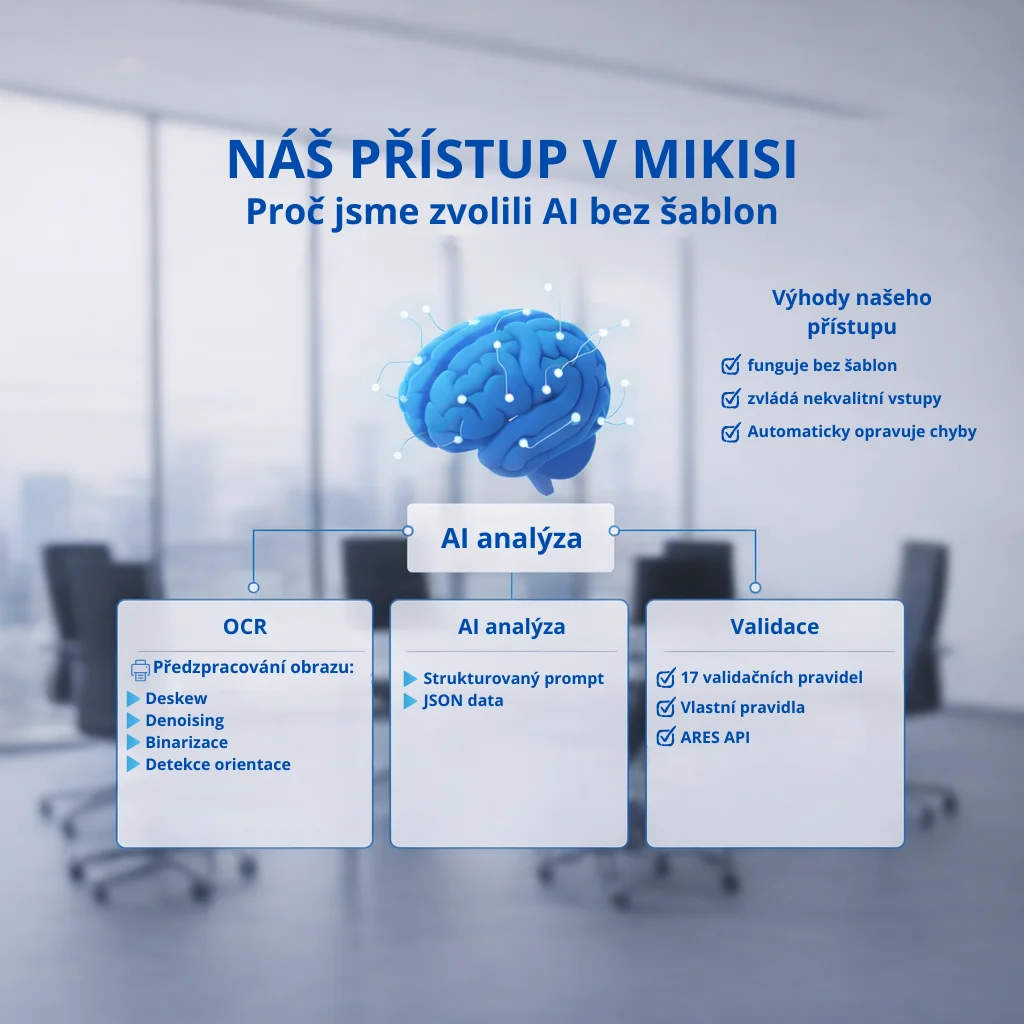
MIKISI kombinuje tři hlavní technologie. Nové účty používají verzi extrakce MIKISI v5, volitelně je k dispozici v4 (Nastavení → Zobrazení → „Verze AI extrakce“).
| Vrstva | Technologie | Účel |
|---|---|---|
| OCR | Google Cloud Vision + Tesseract | Čtení textu z obrázku/PDF |
| AI analýza | Jazykový model, který vidí text i obrázek dokladu | Porozumění struktuře, extrakce dat |
| Validace | Vlastní pravidla + ARES | Kontrola součtů a údajů dodavatele, jednoznačné opravy |
Každá vrstva řeší jiný problém. OCR čte text rychle a levně. AI rozumí kontextu a struktuře. Validace zajišťuje, že data dávají smysl. Kombinace těchto vrstev dosahuje lepších výsledků než kterákoliv vrstva samostatně. Podrobnosti o tom, jak AI zpracování funguje, najdete v článku Jak funguje AI při zpracování faktur.
OCR vrstva — čtení textu
První krok zpracování faktury je převod obrázku na text. Používáme dvě OCR technologie:
Google Cloud Vision
Cloudová služba od Google s velmi vysokou přesností rozpoznávání. Zvládá různé fonty, jazyky (včetně češtiny s háčky a čárkami), a dokonce částečně i rukopis. Je to naše primární OCR engine.
Tesseract (záložní)
Open-source OCR engine. Používáme ho jako zálohu a pro specifické případy, kde Cloud Vision selhává. Tesseract běží lokálně, takže nezávisíme na dostupnosti cloudové služby.
AI analýza — porozumění struktuře
OCR nám dá text, ale neví, co který text znamená. Vidí „12345678", ale neví, že to je IČO. Tady nastupuje AI model.
AI je multimodální model — umí zpracovat jak text, tak obrázky. Posíláme mu:
- Původní obrázek faktury (pro vizuální kontext)
- Text z OCR (pro přesné hodnoty)
- Strukturovaný prompt s instrukcemi
Model analyzuje fakturu a vrací strukturovaná data v JSON formátu:
{
  "supplier_ico": "12345678",
  "supplier_name": "Firma s.r.o.",
  "invoice_number": "FV-2026-0042",
  "date_issued": "2026-02-15",
  "date_due": "2026-03-01",
  "total_amount": 12100.00,
  "currency": "CZK",
  ...
}
Proč AI?
- Rozumí kontextu — pozná, že „Dodavatel" a „IČO" patří k sobě
- Zvládá různé layouty bez předchozího učení
- Čte i z vizuální struktury (tabulky, oddělení sekcí)
- Funguje v češtině bez problémů
Kontrolní pravidla
AI není neomylná. Proto máme třetí vrstvu — kontroly, které ověřují, že vytěžená data dávají smysl:
Údaje dodavatele:
- IČO má 8 číslic a správný kontrolní součet
- IČO existuje v registru ARES
- DIČ odpovídá údajům v ARES
Částky:
- Základ DPH × sazba = DPH (s tolerancí na zaokrouhlení)
- Součet položek = celková částka
- Když součty nesedí, MIKISI v5 sporné položky přečte znovu
Automatické opravy:
Některé chyby umíme opravit automaticky:
- IČO má 7 číslic → doplníme úvodní nulu
- DIČ neodpovídá ARES → doplníme DIČ podle ARES
- DPH nesedí o haléře → sjednotíme podle pravidel zaokrouhlení
📌 Důležité: Automatické opravy provádíme jen u jednoznačných případů. Pokud je situace nejednoznačná, označíme pole k ruční kontrole — raději necháme rozhodnout člověka.
Více o bezpečnosti a ochraně dat najdete v článku Bezpečnost dat.
Proč kombinace funguje
Každá technologie má své slabiny. OCR nerozumí kontextu. AI může „halucinovat" — vymyslet si hodnotu, která na faktuře není. Validace nezachytí všechny chyby.
Ale když je zkombinujete, slabiny se navzájem kompenzují:
- OCR + AI: OCR dává přesné hodnoty, AI dává kontext a strukturu
- AI + Validace: AI extrahuje data, validace ověřuje jejich správnost
- Validace + ARES: Lokální pravidla + externí zdroj pravdy
Výsledkem je systém, který je přesnější než kterákoliv jeho součást samostatně.
Výhody našeho přístupu
Pro uživatele:
- Funguje na faktury od libovolného dodavatele bez nastavování
- Zvládá i fotky z telefonu a skeny
- Kontroly upozorní na nesrovnalosti dřív, než se dostanou do účetnictví
- Chybu ve vytěžení nahlásíte jedním tlačítkem přímo z detailu dokladu
Pro nás jako vývojáře:
- Nemusíme udržovat šablony pro každého dodavatele
- Zlepšování AI se promítne všem uživatelům najednou
- Modulární architektura — můžeme vyměnit OCR nebo AI bez přepsání celého systému
Pro český trh:
- Optimalizováno pro české faktury a české účetní systémy
- Kontrola údajů dodavatele proti registru ARES
- Export do Pohody ve formátu, který Pohoda očekává — viz článek Export dat do účetních systémů
Často kladené otázky
Proč nepoužíváte jen AI bez OCR?
Jazykový model v MIKISI obrázek dokladu vidí, ale text z OCR mu dává přesné hodnoty k porovnání. Model se tak může soustředit na to, co umí nejlépe — porozumění kontextu. Kombinace je spolehlivější než každá technologie zvlášť.
Co když AI model není dostupný?
Při krátkém výpadku se zpracování automaticky zopakuje. Pokud se vytěžení ani tak nepovede, doklad zůstane v přehledu a stačí ho později zpracovat znovu. Pokud je nedostupná Google Cloud Vision, text přečte záložní Tesseract.
Jak řešíte ochranu dat?
Aplikace a databáze MIKISI běží na serveru v ČR, soubory jsou uložené v EU. K vytěžení využíváme zpracovatele Google Cloud Vision a OpenAI (OpenAI zpracovává data v USA na základě DPF/SCC a nepoužívá je k trénování). Podrobnosti najdete na stránkách Bezpečnost a Ochrana osobních údajů.
Učí se váš systém z mých faktur?
Automaticky ne — vaše opravy ani faktury se do modelu nepromítají. Extrakci průběžně vylepšujeme my. Pokud narazíte na chybu, nahlaste ji tlačítkem „Nahlásit chybu v extrakci dat“ v detailu dokladu; vylepšení se pak projeví všem uživatelům.
Plánujete přidat šablony jako doplněk?
Zvažujeme to pro specifické případy — například když má zákazník dodavatele s extrémně nestandardním formátem, kde AI opakovaně selhává. Ale jako primární přístup zůstáváme u AI bez šablon.
Shrnutí
MIKISI kombinuje OCR pro čtení textu, jazykový model pro porozumění struktuře a kontrolní pravidla pro ověření správnosti. Tento přístup bez šablon funguje na faktury od libovolného dodavatele bez předchozího nastavení. Slabiny jednotlivých technologií se navzájem kompenzují, výsledkem je systém přesnější než kterákoliv jeho součást samostatně. Pro uživatele to znamená jednoduchost — nahrajete fakturu, údaje zkontrolujete a předáte do účetnictví.
Chcete začít s MIKISI? Přečtěte si praktický návod Jak začít s MIKISI.
Vyzkoušejte náš přístup
10 dokladů měsíčně zdarma. Nahrajte fakturu a uvidíte, jak to funguje.
Máte technické dotazy? Napište na [email protected].